Kubernetes v1.37: Нативні гістограми переходять в стан бета
З радістю повідомляю, що підтримка нативних гістограм для метрик Kubernetes переходить у стан бета та є стандартно увімкненою в Kubernetes v1.37!
Нативні гістограми (раніше представлені як альфа у Kubernetes v1.36 за KEP-5808) приносять високоточну, низько кардинальну спостережуваність для метрик Kubernetes. Завдяки впровадженню Prometheus Native Histograms, компоненти Kubernetes тепер експонують метрики затримки та тривалості з набагато більшою точністю, значно зменшуючи обсяг зберігання телеметрії та накладні витрати на збирання даних.
Чому варто вийти за межі класичних гістограм??
З самого початку розвитку спостережуваності в Kubernetes показники тривалості та затримки (такі як затримки запитів до сервера API або тривалість планування) базувалися на класичних гістограмах Prometheus.
Класичні гістограми вимагають від авторів метрик визначення статичного списку меж кумулятивних інтервалів (міток le), таких як 0,005; 0,01; 0,025; 0,05; 0,1; 0,25; 0,5; 1; 2,5; 5; 10. Хоча цей підхід є звичним, він створює три основні проблеми:
- Гра у «вгадування інтервалів»: Якщо профіль затримки робочого навантаження змінюється, наприклад, переходить у діапазон мікросекунд або виникають затримки з «довгим хвостом», що виходять за межі найвищого інтервалу, гістограма втрачає наочність. Заздалегідь визначати межі інтервалів можна лише за умови знання розподілу ще до його спостереження
- Висока кардинальність та витрати на зберігання: У класичних гістограмах кожна межа інтервалу експортується як окремий часовий ряд (
_bucket{le="..."}). Гістограма з 10 інтервалами, що охоплюють кілька міток, збільшує кількість часових рядів у 10 разів, що підвищує споживання пам’яті в Prometheus та збільшує витрати на зберігання в базі даних часових рядів (TSDB, time series database). - Похибка інтерполяції в квантилях: Обчислення процентилів за допомогою
histogram_quantile()ґрунтується на лінійній інтерполяції між статичними межами сегментів. Коли діапазони сегментів є грубими, обчислення квантилів можуть мати значну похибку оцінювання.
Що таке нативні гістограми Prometheus?
Prometheus Native Histograms замінює статичні користувацькі інтервали на динамічні, експоненційні інтервали.
Замість того, щоб експортувати окремий часовий ряд для кожної межі інтервалу, нативна гістограма зберігається як один часовий ряд, що містить розширену схему позитивних та негативних інтервалів, нульових порогів і експоненційних коефіцієнтів масштабування.
- Висока роздільна здатність автоматично: Експоненційні інтервали динамічно підлаштовуються під будь-який діапазон значень, від наносекунд до годин, без необхідності попередньо налаштовувати межі інтервалів
- До 90% менше часових рядів: Об’єднуючи інтервали в структуровані діапазони в межах одного часового ряду, значно зменшуються накладні витрати на збирання та зберігання
- Точне обчислення квантилів: Квантилі можна обчислювати з математично обмеженою похибкою (типово ≃5% у гіршому випадку) по всьому спектру спостережень
Як працюють нативні гістограми в Kubernetes
У Kubernetes підтримка нативних гістограм реалізована безпосередньо всередині спільної підсистеми метрик (k8s.io/component-base/metrics).
На малюнку 1 показано, як метрики нативних гістограм обробляються та експортуються в компонентах Kubernetes.
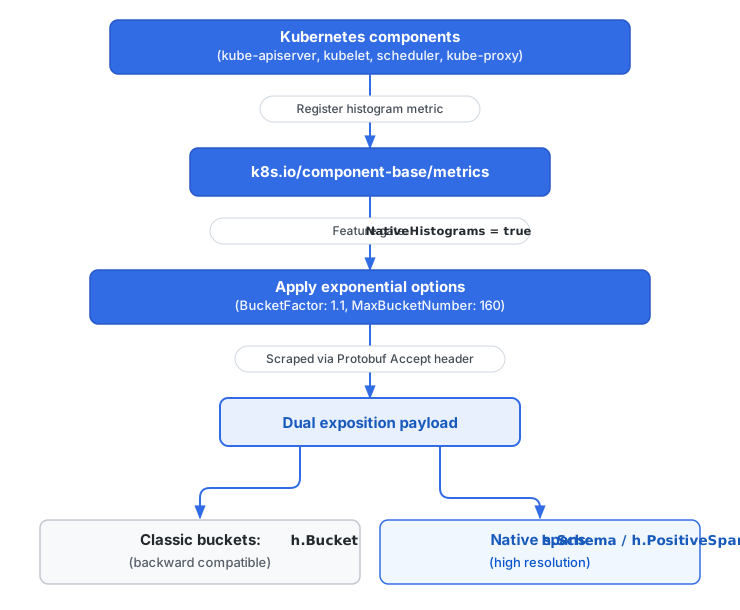
Малюнок 1. Обробка метрик нативних гістограм та подвійний потік експозиції в Kubernetes.
1. Подвійний потік експозиції без порушення сумісності
Основною вимогою до дизайну KEP-5808 було відсутність порушень для наявних стеків спостереження. Коли ввімкнено функціональну можливість NativeHistograms, компоненти Kubernetes використовують подвійний потік експозиції:
- Класичні інтервали (
h.Bucket) все ще експортуються разом із нативними відрізками. Наявні сервери Prometheus, панелі моніторингу та правила оповіщення, які покладаються на традиційне текстове сканування або класичні мітки інтервалів, продовжують працювати без змін - Нативні відрізки (
h.Schema,h.PositiveSpan) включаються в той самий Protobuf-навантаження для колекторів, які розуміють нативні гістограми
2. Налаштована стандартна експоненційна конфігурація
Коли ввімкнено функціональну можливість NativeHistograms, пакунок k8s.io/component-base/metrics автоматично застосовує стандартизовані експоненційні опції до всіх метрик гістограм:
BucketFactor: 1.1: Налаштовує експоненційні інтервали, де кожен інтервал не ширший за 10% порівняно з попереднім. Це гарантує математично обмежену відносну похибку у гіршому випадку на рівні ~5% для обчислення квантилів, незалежно від того, чи операція триває 1 мс або 10 с.MaxBucketNumber: 160: Обмежує максимальну кількість інтервалів на гістограму до 160. Відповідно до рекомендацій OpenTelemetry SDK щодо агрегації експоненційних гістограм з основою 2, це обмеження захищає використання пам’яті компонентів навіть при екстремальних розподілах викидів.
3. Широка підтримка компонентів
Оскільки нативні гістограми інтегровані в component-base/metrics, всі основні компоненти контрольної площини та вузлів Kubernetes автоматично успадковують підтримку, зокрема:
kube-apiserver(наприклад,apiserver_request_duration_seconds, метрики автентифікації/авторизації, затримки валідації)kube-scheduler(наприклад,scheduler_plugin_execution_duration_seconds,scheduler_scheduling_algorithm_duration_seconds)kubelet(метрики рівня вузла для контейнерного середовища та життєвого циклу подів)kube-controller-managerтаkube-proxy
Як збирати нативні гістограми
Просте рішення: оновіть Kubernetes до версії v1.37, і все працюватиме.
Оскільки в Kubernetes v1.37 стандартно увімкнено NativeHistograms, ваш кластер уже експортує метрики з подвійним потоком експозиції. Те, як ви налаштовуєте Prometheus для збору нативних гістограм, залежить від версії Prometheus:
1. Конфігурація збору Prometheus за версією
Prometheus 3.0+ (Рекомендовано): Використовуйте явну конфігурацію для кожного завдання у вашому
scrape_configsзамість глобальних прапорців (глобальний прапорець--enable-feature=native-histogramsзастарів у Prometheus 3.9+):scrape_configs: - job_name: 'kubernetes-apiservers' scrape_native_histograms: true always_scrape_classic_histograms: true # Recommended during transitionОбов’язково ознайомтеся з застереженням у розділі Міграція панелей і сповіщень у документації щодо нативних гістограм. Підсумок: завжди встановлюйте
always_scrape_classic_histograms: trueпід час перехідного періоду. Без цього налаштування Prometheus буде збирати лише нативний формат і припинить збір класичних серій_bucket,_countта_sum. Встановленняalways_scrape_classic_histograms: trueгарантує, що існуючі панелі (histogram_quantile(..._bucket...)) і сповіщення продовжують працювати, поки ви мігруєте їх на нативні гістограми.Prometheus 2.40 – 2.x: Увімкніть нативні гістограми глобально, запустивши Prometheus з відповідним прапорцем:
prometheus --enable-feature=native-histogramsЗверніть увагу, що в Prometheus 2.x це налаштування "все або нічого" для всіх цілей збору.
2. Перевірка подвійного потоку експозиції Protobuf
Стандартне сканування Prometheus у текстовому форматі (application/openmetrics-text або plain text) передає лише класичні інтервали. Коли увімкнено scrape_native_histograms, Prometheus автоматично домовляється про Protobuf формат з точками доступу Kubernetes.
Ви можете перевірити, що компонент Kubernetes експортує нативні гістограми, використовуючи curl з заголовком Accept, що вказує Protobuf. Наприклад:
## ЦЕ НЕБЕЗПЕЧНО. РОБІТЬ ЦЕ ЛИШЕ В ТЕСТОВОМУ КОНТЕКСТІ.
curl --insecure \
  -H "Accept: application/vnd.google.protobuf;proto=io.prometheus.client.MetricFamily;encoding=delimited" \
  --header "Authorization: Bearer $(cat /var/run/secrets/kubernetes.io/serviceaccount/token)" \
  https://localhost:6443/metrics
Після декодування повернене MetricFamily для метрик гістограми (наприклад, apiserver_request_duration_seconds) міститиме як традиційні записи bucket, так і заповнені поля schema / positive_span.
Запити нативних гістограм у PromQL
Після того як нативні гістограми будуть імпортовані в Prometheus, ви можете запитувати їх, використовуючи стандартні функції гістограм PromQL без необхідності статичних міток le або суфіксів _bucket:
# 1. Розрахунок затримки P99 для однієї цілі:
# Класична гістограма (потрібен суфікс _bucket):
histogram_quantile(0.99, rate(apiserver_request_duration_seconds_bucket[5m]))

# Нативна гістограма (працює безпосередньо з назвою метрики):
histogram_quantile(0.99, rate(apiserver_request_duration_seconds[5m]))

# 2. Агрегація по кількох інстансах (наприклад, усі API сервери):
# Класична гістограма (потрібен sum by (le), щоб зберегти межі інтервалів):
histogram_quantile(0.99, sum by (le) (rate(apiserver_request_duration_seconds_bucket[5m])))

# Нативна гістограма (групування за le не потрібне!):
histogram_quantile(0.99, sum(rate(apiserver_request_duration_seconds[5m])))
З нативними гістограмами функції на кшталт histogram_quantile() працюють безпосередньо з динамічними експоненційними інтервалами всередині часових рядів, забезпечуючи високу точність квантилів без помилок інтерполяції статичних бакетів.
Для офіційної документації щодо запитів нативних гістограм у PromQL дивіться:
- PromQL
histogram_quantiledocumentation - PromQL
histogram_fractiondocumentation - PromQL
histogram_sumdocumentation - PromQL
histogram_countdocumentation - PromQL
histogram_countdocumentation - PromQL
histogram_stddevandhistogram_stdvardocumentation
Міграція дашбордів та стратегія відкату
Рекомендований порядок міграції
Щоб безпечно перейти на нативні гістограми у вашій системі моніторингу, не порушуючи існуючі алерти чи дашборди, рекомендую чотирьохетапний порядок міграції:
- Увімкніть обидва формати: У конфігурації Prometheus 3.x для збирання даних встановіть
scrape_native_histograms: trueІalways_scrape_classic_histograms: true, щоб обидва формати збиралися безпечно під час переходу - Міграція запитів: Оновіть ваші дашборди Grafana та правила алертів Prometheus з класичних запитів квантилів (
histogram_quantile(..._bucket...)) на запити нативних гістограм (histogram_quantile(...)), і замініть посилання на класичні серії_countта_sumнаhistogram_count(...)таhistogram_sum(...) - Перевірка в Staging/Production: Переконайтеся, що всі дашборди та алерти SLO спрацьовують і відображаються правильно, використовуючи нові запити нативних гістограм
- Відкрийте ~10x економію місця: Після завершення міграції встановіть
always_scrape_classic_histograms: false. Prometheus припинить збирати статичні часові ряди_bucket,_countта_sum, зменшуючи кількість часових рядів гістограм на 90%!
Відмова та гнучкість відкату
Оскільки нативні гістограми подвійно експонуються, їх використання є повністю опціональним з точки зору колектора:
- Миттєвий відкат колектора: Якщо потрібно припинити збір нативних гістограм, просто встановіть
scrape_native_histograms: falseу конфігурації завдання Prometheus. Перезапуск Kubernetes не потрібен, і Prometheus негайно відновить збір лише класичного формату без втрати даних - Відкат через функціональну можливість компоненту: Адміністратори також можуть вимкнути фунгкціональну можливість на компонентах Kubernetes, використовуючи
--feature-gates=NativeHistograms=false(потребує перезапуску компоненту)
Що далі та як долучитися
Оскільки нативні гістограми наближаються до загальної доступності (GA) у майбутніх випусках Kubernetes, SIG Instrumentation продовжуватиме оцінювати готовність екосистеми, характеристики продуктивності та довгострокові плани щодо поступової відмови від статичних класичних інтревалів, коли використання нативних гістограм стане поширеним у спільноті моніторингу.
- Ознайомтеся з KEP-5808 page або з KEP GitHub issue, щоб дізнатися більше.
- Ознайомтеся з Prometheus Native Histograms specification та PromQL querying functions documentation
- Долучайтеся до SIG Instrumentation у Slack у #sig-instrumentation або приєднуйтеся до щотижневих зустрічей SIG
Подяки
Щира подяка всім учасникам SIG Instrumentation та власникам компонентів, які співпрацювали над дизайном, реалізацією, тестуванням та оглядом нативних гістограм у Kubernetes!